
OpenClaw: cos’è, cosa fa e come funziona il nuovo assistente AI open source
3 Febbraio 2026 - 9 minuti
20 Ottobre 2026
Un file Excel con migliaia di righe, i risultati di una campagna pubblicitaria, l’andamento delle vendite dell’ultimo trimestre. Fino a qualche tempo fa, interpretare queste informazioni richiedeva una certa familiarità con formule, dashboard e strumenti di analisi. Adesso possiamo caricare un documento in un assistente AI e chiedere direttamente: «Che cosa sta succedendo?».
La risposta arriva in pochi secondi. Spesso contiene percentuali, confronti, tendenze e persino suggerimenti su quali decisioni prendere.
È una possibilità interessante per chi lavora nel marketing, gestisce un’attività o deve orientarsi quotidianamente tra numeri e indicatori. L’intelligenza artificiale rende accessibili operazioni che in precedenza richiedevano competenze tecniche specifiche e parecchio tempo.
Rimane però una domanda difficile da ignorare: quanto possiamo fidarci di quelle conclusioni?
Un’analisi formulata con sicurezza può contenere errori di calcolo, interpretazioni discutibili o correlazioni prive di significato. E chi riceve il risultato potrebbe accorgersene soltanto dopo aver preso una decisione.
La questione assume un peso particolare quando l’AI entra nei processi aziendali. Perché una cosa è chiedere a un chatbot di riassumere un documento. Un’altra è affidargli informazioni che determineranno investimenti, budget e strategie commerciali.
La rapidità con cui i modelli linguistici elaborano informazioni ha contribuito a diffondere una convinzione: se l’AI riesce a produrre un’analisi dettagliata, probabilmente ha anche compreso i dati su cui sta lavorando.
Le ricerche scientifiche invitano a distinguere queste due capacità.
Nel capitolo dedicato all’intelligenza artificiale responsabile dell’AI Index Report 2026 della Stanford University, emerge un dato significativo. In un benchmark specifico sull’accuratezza, i tassi di allucinazione registrati su 26 modelli AI di primo piano oscillano tra il 22% e il 94%.
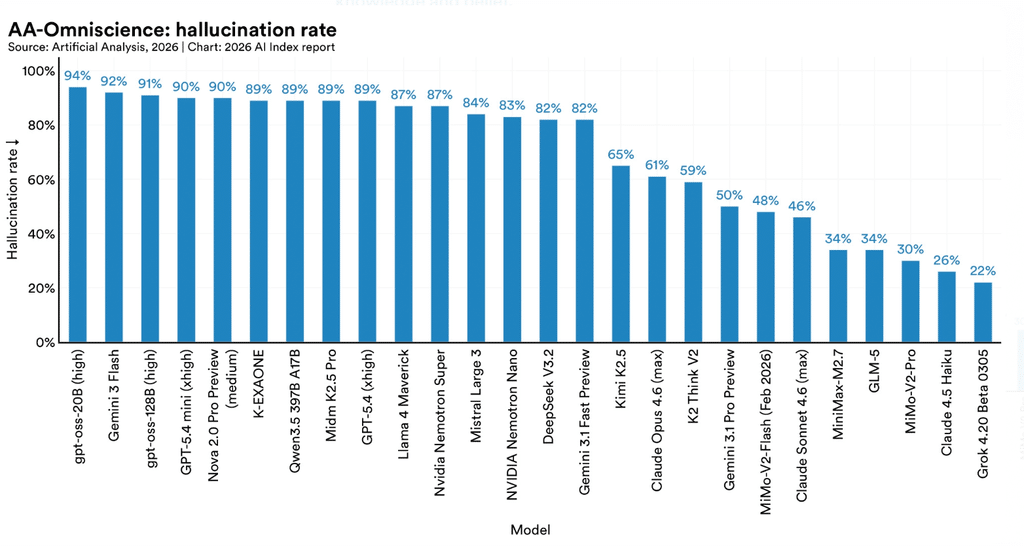
Una forbice molto ampia, che rivela differenze sostanziali tra i sistemi esaminati.
Il dato richiede una precisazione: il benchmark misura un particolare tipo di affidabilità delle risposte e quei valori non rappresentano la percentuale generale di errori commessi dall’AI nell’analisi di fogli di calcolo o database.
Resta comunque un’indicazione rilevante. Un modello può produrre risposte linguisticamente impeccabili pur mostrando difficoltà nel riconoscere informazioni false o nel gestire correttamente ciò che sa.
Per chi utilizza questi strumenti in azienda, il rischio si presenta sotto una forma molto concreta.
Immaginiamo di chiedere all’AI di analizzare i risultati di una campagna pubblicitaria. Il sistema individua un aumento del traffico, confronta le performance dei canali e suggerisce di spostare il budget verso quello apparentemente più efficace.
La raccomandazione sembra ragionevole. Ma cosa succede se il modello ha confrontato periodi differenti, interpretato male un campo del dataset o trascurato il costo di acquisizione dei clienti?
Una conclusione convincente può diventare il punto di partenza di una scelta economicamente sbagliata.
Il problema riguarda quindi la qualità del ragionamento, oltre alla correttezza dei singoli numeri.
Per comprendere questi errori occorre guardare al funzionamento dei modelli linguistici.
I Large Language Model, o LLM, elaborano richieste e generano risposte attraverso meccanismi statistici appresi durante l’addestramento. Sono particolarmente efficaci nel riconoscere strutture, interpretare linguaggio naturale e produrre spiegazioni coerenti.
Queste capacità, però, non garantiscono che ogni affermazione sia stata verificata rispetto a una fonte o calcolata con un procedimento matematico corretto.
Il National Institute of Standards and Technology, nel suo framework dedicato ai rischi dell’AI generativa, affronta il fenomeno delle confabulations: contenuti falsi o inesatti che i sistemi possono presentare come attendibili.
Nel linguaggio comune vengono spesso chiamati allucinazioni.
La caratteristica più insidiosa è l’apparente normalità della risposta. Un modello può costruire una spiegazione articolata, utilizzare terminologia tecnica e organizzare i risultati in una tabella ordinata anche quando una parte del ragionamento contiene errori.
Consideriamo un ecommerce che registra un aumento delle vendite del 20% rispetto al mese precedente.
L’intelligenza artificiale potrebbe interpretarlo come un miglioramento delle performance commerciali e suggerire di aumentare gli investimenti pubblicitari.
Prima di considerare valida quella raccomandazione, però, bisognerebbe conoscere alcune informazioni: quanto è aumentata la spesa pubblicitaria? Sono cambiati i prezzi? Il periodo comprende promozioni particolari? È cresciuto il numero degli ordini oppure il loro valore medio?
Se il fatturato aumenta del 20% mentre gli investimenti pubblicitari crescono del 60%, la lettura dei risultati cambia sensibilmente.
Il numero iniziale rimane corretto. È la sua interpretazione a diventare discutibile.
Ecco perché accuratezza e comprensione del contesto devono essere valutate separatamente.
L’AI può riconoscere una variazione percentuale senza disporre di tutti gli elementi necessari per attribuirle un significato economico.
Lo stesso vale per molte altre attività: dall’analisi delle conversioni di un sito alle previsioni di domanda, fino alla valutazione delle performance di un team commerciale.
Il vero rischio emerge quando un’ipotesi generata dal sistema viene trattata come una conclusione verificata.
Uno degli utilizzi più immediati dell’intelligenza artificiale consiste nel caricare file CSV, tabelle e fogli di calcolo per ottenere analisi in linguaggio naturale.
È anche uno dei terreni sui quali la ricerca sta cercando di misurare meglio l’affidabilità dei modelli.
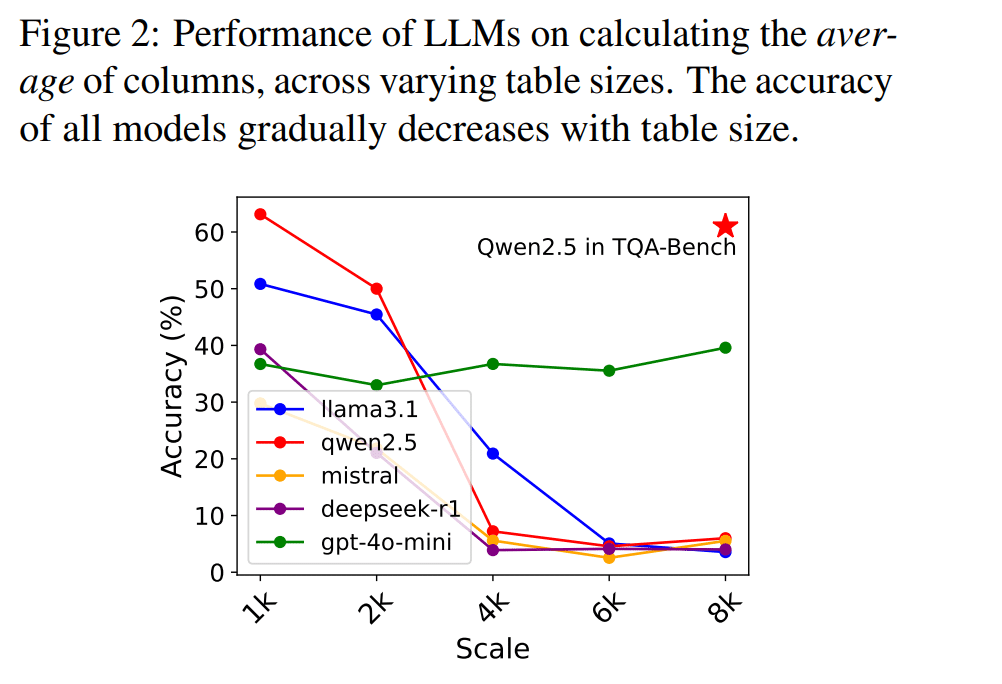
Nel luglio 2025, Cornelius Wolff e Madelon Hulsebos hanno pubblicato lo studio How well do LLMs reason over tabular data, really?
I ricercatori hanno esaminato le capacità dei modelli linguistici generalisti di ragionare su dati organizzati in tabelle, concentrandosi sulla loro robustezza in situazioni realistiche.
Il lavoro ha evidenziato difficoltà significative quando le informazioni presentano caratteristiche comuni nei dataset reali. Tra queste figurano valori mancanti, entità duplicate e variazioni nella struttura delle tabelle.
Sono problemi che qualsiasi professionista abituato a lavorare con dati aziendali conosce bene.
Un database clienti può contenere la stessa persona registrata con indirizzi email differenti. Un report commerciale può avere celle vuote. Un file esportato da una piattaforma può cambiare formato da un mese all’altro.
Le persone che analizzano questi documenti devono comprendere come trattare le anomalie prima di produrre un risultato attendibile.
I modelli linguistici possono incontrare difficoltà proprio in questi passaggi.
Immaginiamo un’azienda con 15.000 contatti nel proprio CRM.
Alcuni clienti compaiono più volte perché hanno effettuato acquisti utilizzando recapiti differenti. Altri record sono incompleti. Alcuni campi riportano informazioni aggiornate, altri conservano dati vecchi.
Se chiediamo all’AI di calcolare il numero di clienti attivi o la frequenza media di acquisto, la qualità della risposta dipenderà anche dal modo in cui il sistema gestisce questi problemi.
Contare ogni riga come un cliente distinto potrebbe gonfiare il risultato. Escludere automaticamente tutte le righe incomplete potrebbe eliminare informazioni utili.
Esiste poi un’ulteriore complicazione: la definizione stessa di cliente attivo.
Parliamo di chi ha acquistato negli ultimi 30 giorni? Negli ultimi 12 mesi? Di chi ha semplicemente effettuato l’accesso alla piattaforma?
Senza una definizione condivisa, due analisi dello stesso database possono produrre numeri differenti ed essere entrambe coerenti con le rispettive ipotesi.
I risultati dello studio di Wolff e Hulsebos indicano quanto sia importante valutare i modelli su dati che riflettano queste complessità, piuttosto che limitarsi a test costruiti su tabelle idealmente ordinate.
Per un’azienda, la conseguenza è immediata: la preparazione dei dati condiziona la qualità delle risposte.
Affidare un dataset disordinato all’intelligenza artificiale e aspettarsi automaticamente un’analisi attendibile espone agli stessi problemi che incontrerebbe un analista umano, con la difficoltà aggiuntiva di capire quali operazioni siano state effettivamente eseguite.
È anche il motivo per cui la capacità di interrogare correttamente i dati sta diventando una competenza trasversale. Un tema che trova spazio nella Ninja Week – Halloween Edition, la settimana di webinar gratuiti dedicati all’uso pratico dell’AI, con un appuntamento specifico sul passaggio dall’analisi alle decisioni.
Tra le attività per cui l’intelligenza artificiale viene utilizzata con maggiore interesse c’è l’individuazione di relazioni tra variabili.
Un assistente può confrontare dati di vendita, investimenti pubblicitari, traffico web e comportamento degli utenti, segnalando le associazioni statistiche più evidenti.
Il rischio nasce quando queste associazioni vengono interpretate come rapporti di causa ed effetto.
Supponiamo che un’azienda rilevi un aumento delle vendite nei periodi in cui pubblica più contenuti sui social media.
L’AI potrebbe evidenziare una correlazione positiva e suggerire di intensificare la produzione di contenuti.
È una possibile ipotesi di lavoro. Per trasformarla in una conclusione servirebbero però ulteriori verifiche.
Le vendite potrebbero essere influenzate dalla stagionalità, da promozioni commerciali, dall’aumento della domanda o da campagne pubblicitarie attive contemporaneamente.
Il fatto che due fenomeni si verifichino insieme indica una relazione statistica, ma la correlazione da sola non dimostra la causalità.
Questa distinzione è particolarmente importante nel digital marketing, dove numerose variabili cambiano contemporaneamente e le piattaforme restituiscono grandi quantità di indicatori.
Un modello linguistico può aiutare a individuare relazioni interessanti, formulare ipotesi e suggerire ulteriori analisi. Per stabilire l’effetto causale di un intervento, invece, possono essere necessari esperimenti controllati, test incrementali o metodi statistici appropriati.
Le decisioni diventano più solide quando ogni suggerimento viene accompagnato dalla domanda giusta: quali dati dimostrano realmente questa conclusione?
Le difficoltà emerse dalla ricerca scientifica descrivono i limiti attuali di una tecnologia che offre già applicazioni utili.
Per molti professionisti, il vantaggio più immediato consiste nella possibilità di esplorare informazioni complesse senza dover costruire manualmente ogni interrogazione.
Un responsabile marketing può chiedere di confrontare le performance di diverse campagne. Un freelance può utilizzare l’AI per organizzare i dati delle proprie attività. Un imprenditore può richiedere una sintesi preliminare dei risultati commerciali.
In questi casi, il sistema contribuisce a ridurre il tempo necessario per orientarsi tra le informazioni.
Particolarmente interessante è la capacità di trasformare domande formulate in linguaggio naturale in operazioni di analisi.
Una richiesta come «Quali prodotti hanno registrato il calo maggiore rispetto al trimestre precedente?» può essere tradotta in filtri, confronti e rappresentazioni grafiche, soprattutto quando l’assistente dispone di strumenti in grado di eseguire codice e calcoli verificabili.
La differenza rispetto a una risposta puramente testuale è sostanziale.
Se il modello genera ed esegue uno script per elaborare i dati, diventa possibile controllare le formule utilizzate, ricostruire i passaggi e individuare eventuali anomalie.
Questo rende l’analisi più ispezionabile, pur senza eliminare il rischio di errori nel codice, nelle ipotesi o nell’interpretazione finale.
L’intelligenza artificiale può inoltre facilitare attività preliminari spesso impegnative, come identificare campi incompleti, suggerire controlli di qualità o aiutare a documentare il significato delle variabili.
Sono applicazioni nelle quali il contributo della tecnologia può essere concreto e misurabile.
Occorre però distinguere l’assistenza nella preparazione e nell’esplorazione dei dati dalla responsabilità di validare le conclusioni.
Una risposta ben scritta può generare un senso di sicurezza difficile da mettere in discussione. Per questo, quando l’AI viene utilizzata per interpretare dati destinati a decisioni importanti, servono procedure di verifica riconoscibili.
Le raccomandazioni del NIST sulla gestione dei rischi dell’intelligenza artificiale offrono un riferimento utile per costruire processi più affidabili.
Nella pratica quotidiana, il controllo può partire da cinque aspetti.
Prima di chiedere un’analisi, occorre conoscere la provenienza del dataset, il periodo di riferimento e il significato dei campi.
Bisogna anche identificare duplicati, valori mancanti e possibili anomalie.
Un modello può aiutare a eseguire questi controlli, ma i criteri con cui vengono trattate le informazioni devono essere espliciti.
Una percentuale isolata offre poche garanzie.
È preferibile richiedere la formula utilizzata, le variabili considerate, gli eventuali filtri applicati e i passaggi del calcolo.
Quando possibile, conviene verificare i risultati attraverso strumenti deterministici, come query SQL, fogli di calcolo o script eseguibili.
La spiegazione generata dal chatbot è utile per comprendere il procedimento dichiarato. La possibilità di riprodurre effettivamente il calcolo offre una garanzia maggiore.
Un buon report dovrebbe rendere riconoscibile la differenza tra dati osservati, ipotesi e raccomandazioni.
«Il tasso di conversione è sceso dal 3% al 2,4%» descrive un risultato numerico.
«Il calo è stato causato dalla nuova versione della landing page» introduce una spiegazione causale che richiede prove ulteriori.
Questa distinzione aiuta a evitare decisioni fondate su interpretazioni premature.
Le anomalie individuate dall’AI possono essere controllate attraverso dashboard, report precedenti o altre fonti interne.
Per analisi particolarmente importanti, una verifica indipendente del calcolo riduce il rischio che lo stesso errore venga riprodotto in più passaggi.
Conta anche il confronto con chi conosce i processi aziendali. Un dato apparentemente anomalo potrebbe essere spiegato da una modifica nel sistema di tracciamento, da una campagna promozionale o da un cambiamento operativo.
La responsabilità deve essere chiara, soprattutto quando un’analisi produce conseguenze economiche o organizzative.
L’AI può suggerire scenari alternativi, stimare risultati e mettere in evidenza informazioni trascurate.
La decisione richiede però una valutazione dei rischi, degli obiettivi e delle condizioni che i dati potrebbero descrivere solo parzialmente.
È proprio sul rapporto tra analisi e scelte operative che si concentra il webinar “Decidere con l’AI: dai dati alle decisioni”, previsto per il 29 ottobre 2026 durante la Ninja Week – Halloween Edition, alla quale è possibile iscriversi gratuitamente.
L’incontro, condotto da Mattia Minafò, Senior Data Architect e Co-Founder di Tillde, affronta la costruzione di scenari e il confronto tra alternative, con attenzione alla verifica delle fonti, delle ipotesi e dei limiti delle analisi.
C’è un aspetto che riguarda direttamente il comportamento delle persone.
Si chiama automation bias ed è la tendenza ad attribuire un peso eccessivo alle indicazioni prodotte dai sistemi automatizzati, anche quando esistono elementi che suggerirebbero di verificarle.
Il fenomeno precede la diffusione dell’AI generativa, ma l’interazione conversazionale può renderlo particolarmente interessante da osservare.
Una dashboard tradizionale mostra indicatori che devono essere interpretati. Un assistente AI può presentarli già organizzati all’interno di una spiegazione, aggiungendo valutazioni e suggerimenti.
Questo passaggio modifica il rapporto tra utente e informazione.
Quando leggiamo una risposta chiara, completa e formulata con un linguaggio autorevole, diventa più facile attribuirle credibilità.
Un manager sotto pressione potrebbe accettare la raccomandazione di ridurre gli investimenti su un determinato canale. Un professionista potrebbe modificare il prezzo di un servizio sulla base di una previsione. Un team potrebbe considerare risolto un problema dopo aver ricevuto una spiegazione apparentemente convincente.
La qualità della decisione dipende anche dalla capacità di riconoscere le condizioni in cui l’automazione merita fiducia e quelle in cui richiede una verifica aggiuntiva.
I controlli dovrebbero essere proporzionati alle conseguenze dell’errore.
Una classificazione preliminare di commenti sui social può tollerare un certo margine di imprecisione, purché sia noto. Un’analisi che determina un investimento significativo richiede livelli di verifica più elevati.
Il tempo risparmiato grazie all’AI acquista valore quando viene utilizzato per migliorare l’analisi, anziché eliminare ogni controllo.
Un altro elemento importante riguarda il tipo di domanda che poniamo all’intelligenza artificiale.
Chiedere quanto sono aumentate le vendite negli ultimi sei mesi è diverso dal domandare quanto cresceranno nel semestre successivo.
Nel primo caso, il sistema lavora su dati storici e può eseguire operazioni descrittive verificabili.
Nel secondo deve formulare una previsione.
Entrano quindi in gioco ipotesi sull’andamento futuro del mercato, sui comportamenti dei consumatori e sulle condizioni economiche.
Anche con dati storici accurati, una previsione può risultare sbagliata perché le condizioni cambiano.
Supponiamo che un’azienda abbia registrato una crescita media delle vendite del 5% mensile durante un trimestre.
Proiettare automaticamente questo andamento sui dodici mesi successivi produrrebbe una stima numerica semplice, ma potenzialmente poco realistica.
La crescita potrebbe rallentare, il mercato potrebbe raggiungere una fase di saturazione o la domanda potrebbe risentire di fattori stagionali.
Un’analisi previsionale attendibile dovrebbe esplicitare le ipotesi, considerare scenari differenti e comunicare l’incertezza del risultato.
L’AI può contribuire a questo lavoro, soprattutto se integrata con strumenti statistici adeguati.
Diventa invece rischioso trattare una previsione generata in linguaggio naturale come un risultato già validato.
Per chi deve pianificare budget, investimenti o attività commerciali, l’incertezza è parte dell’informazione.
Una stima accompagnata dai suoi limiti è generalmente più utile di una cifra precisa priva di spiegazioni.
L’accessibilità degli strumenti di intelligenza artificiale sta cambiando il modo in cui le persone interagiscono con i dati.
Operazioni che prima richiedevano conoscenze specifiche possono essere avviate attraverso una semplice richiesta scritta. Questo amplia le possibilità di analisi per figure professionali che tradizionalmente utilizzavano soprattutto report e dashboard già pronti.
Allo stesso tempo, rende più importante saper valutare la qualità delle risposte.
Chi utilizza l’AI deve essere in grado di formulare domande pertinenti, comprendere il significato degli indicatori e riconoscere quando una conclusione richiede approfondimenti.
Pensiamo a un responsabile marketing che vuole individuare le campagne più efficaci.
Potrebbe chiedere all’intelligenza artificiale di ordinare i risultati in base al numero di conversioni. Otterrebbe rapidamente una classifica.
Ma un’analisi utile dovrebbe considerare anche il costo per acquisizione, il valore dei clienti generati, il periodo di attribuzione e gli obiettivi specifici delle campagne.
La differenza emerge dalla capacità di scegliere i criteri corretti.
Per questo la familiarità con i concetti di base della statistica, della misurazione e dell’analisi dei dati rimane preziosa anche per chi utilizza strumenti AI avanzati.
Cresce inoltre l’importanza di comprendere come vengono elaborati i dati, quali strumenti eseguono effettivamente i calcoli e quali limiti caratterizzano i risultati.
L’intelligenza artificiale può accelerare il lavoro di analisi. Le competenze professionali permettono di orientarlo verso domande rilevanti.
È una distinzione che coinvolge direttamente freelance, marketer, imprenditori e manager, soprattutto quando la disponibilità di nuovi strumenti porta a sperimentare processi decisionali più automatizzati.
Le ricerche sull’affidabilità dell’intelligenza artificiale mostrano un quadro articolato.
I modelli linguistici possono elaborare grandi quantità di informazioni, supportare l’esplorazione dei dataset e rendere più accessibili strumenti di analisi complessi.
Possono anche commettere errori, interpretare male dati incompleti e formulare conclusioni che sembrano solide pur poggiando su ipotesi fragili.
La differenza, per chi li utilizza professionalmente, sta nella possibilità di riconoscere e gestire questi limiti.
Un’analisi AI diventa più affidabile quando i dati sono controllati, i calcoli possono essere riprodotti e le conclusioni vengono confrontate con evidenze indipendenti.
Conta anche la capacità di porre domande migliori: chiedere a un modello di individuare una tendenza è utile ma chiedergli quali elementi potrebbero smentire la sua interpretazione può esserlo ancora di più.
L’obiettivo dovrebbe essere costruire processi nei quali velocità e controllo convivano.
Prima di modificare una strategia commerciale, aumentare un investimento o ridistribuire un budget sulla base di una risposta generata dall’AI, vale la pena fare un’ultima verifica: quale evidenza sostiene davvero questa decisione?
Perché un numero può essere corretto, una spiegazione può sembrare convincente e la conclusione può comunque essere sbagliata.
Ed è proprio in quella distanza tra dato e decisione che il giudizio umano continua a fare la differenza.
Potrebbe interessarti anche
Potrebbe interessarti anche
Corsi, articoli, eventi: il mondo Ninja è ricco di risorse e di appuntamenti da non perdere.
Please confirm you want to block this member.
You will no longer be able to:
Please allow a few minutes for this process to complete.